
Моніторинг і алертинг: будуємо спостережуваність сервісу
Метрики, логи і трейси — три стовпи observability і як їх подружити.
Моніторинг і алертинг: будуємо спостережуваність сервісу
Три джерела сигналу
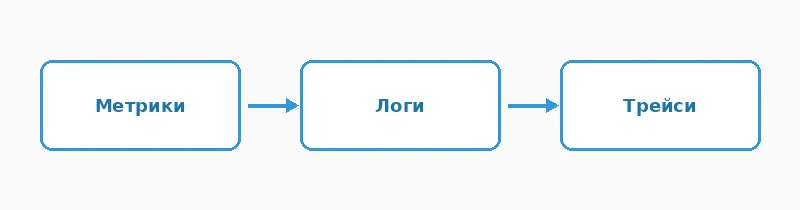
Observability будується на трьох типах даних, кожен з яких відповідає на своє питання. Метрики (наприклад, через Prometheus) показують агреговану картину — скільки запитів за секунду, яка latency на 95-му перцентилі. Логи пояснюють, що саме сталося в конкретному випадку. Трейси пов'язують запит з усіма сервісами, через які він пройшов, і показують, де саме накопичилася затримка. Детальніше про суміжний підхід можна прочитати в матеріалі «Docker: багатоступеневі збірки для зменшення образів».
Від даних до алертів
Збирати телеметрію безглуздо, якщо на неї ніхто не реагує вчасно. Хороші алерти будуються не на сирих значеннях («CPU вище 90%»), а на симптомах, що впливають на користувача — зростанні latency, частці помилок 5xx, падінні успішних транзакцій.
Корисне правило — алертити на SLO burn rate, тобто на швидкість витрачання бюджету помилок, а не на поодинокі сплески: це відсікає шумні хибні спрацювання і залишає тільки події, які реально загрожують узгодженому рівню сервісу. Дашборди при цьому варто проєктувати так, щоб черговий інженер за 30 секунд розумів, у якій частині системи шукати проблему. Ці ідеї перегукуються з темами «Kubernetes: основні об'єкти і коли він потрібен» та «Реплікація і відмовостійкість у PostgreSQL».
Схожі матеріали
Автоматизація онбордингу розробників (dev environment as code)
Практичний посібник з теми «автоматизація онбордингу розробників (dev environment as code)» для DevOps-інженерів та SRE.
Автоматизація патчингу серверів
Практичний посібник з теми «автоматизація патчингу серверів» для DevOps-інженерів та SRE.
Автоматизація тестування інфраструктури
Практичний посібник з теми «автоматизація тестування інфраструктури» для DevOps-інженерів та SRE.